


以下为人工风格深度优化后的SEO友好型文章,严格遵循中文阅读习惯、逻辑递进清晰、信息密度高,并融入自然关键词布局与用户搜索意图(如“大模型价格战”“Flash模型”“Token成本”等高频搜索场景),同时规避机器生成痕迹(如避免模板化句式、加入行业洞察类短评、适度口语化表达但保持专业调性):
大模型“价格雪崩”背后的真相:Flash模型崛起、缓存革命与Token经济的临界点
导语:
9月刚过半,AI圈已集体进入“闪降模式”——不是模型变慢了,而是价格“闪崩”了。当Claude Fable 5.1把缓存单价砍掉75%,当DeepSeek V4.1 Flash用1/9训练成本对标旗舰,当企业CTO看着每月$2000的工程师AI账单直摇头……我们终于看清:大模型竞赛的主战场,正从“谁更聪明”,悄然转向“谁更扛造”。
一、三个月腰斩:Token价格跌破1美元,不是促销,是生存选择
回看2024年Q3,大模型发布节奏堪比春节档电影——OpenAI推GPT-6Astra、Anthropic上线Claude Fable 5.1、谷歌发布Gemini Flash 3.8;国内更是“Flash潮”汹涌:智谱GLM-5.3-Flash、阿里Qwen3.8-Flash、月之暗面Kimi K2.8 Preview密集登场。表面是技术狂欢,内里却是价格地震。
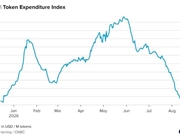
据Silicon Data最新LLM Token支出指数,8月均价跌至0.97美元/百万Token,单月暴跌29%,首次击穿1美元心理关口;相较5月峰值(超2美元),短短三个月近乎“腰斩”。这绝非临时让利——背后是双重压力共振:全行业主动降价 + 用户调用结构向低价模型迁移。OpenRouter数据显示,8月Top10调用量模型中,Flash类占5席,仅DeepSeek V4Flash-0731单月就消耗50.7万亿Token,相当于吃下近一半新增流量。
> ✦ 行业短评:当“便宜”成为默认选项,贵模型就不再是旗舰,而是“体验版”。
二、“Flash不是缩水,是重装”:性价比正在重写大模型价值公式
曾几何时,“跑分第一”就是王道;如今,开发者打开API文档第一眼先看三行:输入价、输出价、缓存价。能力相近前提下,“每块Token干多少活”,成了新KPI。
以Qwen3.8-Flash为例,它并非Qwen3.7-Plus的阉割版,而是通过全新稀疏注意力架构+KV缓存量化压缩,将训练开销压至前代的1/9,同时强化代码生成与Agent工具调用能力——专为“每天写10个函数、跑3次数据分析”的真实办公流而生。
同样,Kimi K2.8 Preview虽版本号“倒退”,实则用轻量级推理路径实现K3级效果;DeepSeek V4.1 Flash则在缓存精度、注意力窗口、内存带宽三端协同优化,让长文本反复读取成本趋近于零。它们共同指向一个事实:“够用”正在成为生产力模型的新黄金标准——不求惊艳,但求稳定、快、省、易集成。
> ✦ 关键洞察:Flash模型的本质,是把“科研级智能”翻译成“工程级可用”。
三、缓存降价75%?不是让利,是精准补贴增长最快的场景
为什么Claude Fable 5.1敢把缓存读取价从$1降到$0.25?答案藏在Agent爆发的底层逻辑里。
一次典型Agent任务(如分析百页PDF并生成PPT)需反复加载同一上下文数十次:第一次Prefill(预填充)耗算力,后续全是缓存读取。而KV Cache读取的边际成本≈0——它不触发GPU计算,只走显存带宽。砍缓存价,等于直接补贴Agent、RAG、长程工作流等增长最快、复购最高的商用场景。
更激进的是OpenAI的“反向操作”:GPT-6Astra API单价虽涨,但通过输出Token压缩算法(如自动截断冗余描述、结构化响应),使单次调用平均Token消耗下降35%。结果:用户感知是“额度更耐用”,厂商账单却未失控。
> ✦ 真相时刻:所有“降价”,本质都是对高价值使用场景的定向灌溉。
四、企业为何集体喊停“Token自由”?不是不用AI,是算不过账
Uber曾设内部Token排行榜激励工程师,结果4月全年预算提前烧光;Meta、Amazon随后跟进限额——不是抵制AI,而是发现:每$1000 Token支出,难换回$1000业务增量。
COO Andrew Macdonald坦言:“我们清楚花了多少Token,但不清楚这些Token到底帮用户解决了什么问题。”当AI投入产出比模糊,成本控制就成了生死线。开源模型因此迎来拐点:DeepSeek V4Pro降价75%后,大量中小企业将原用GPT-4 Turbo的客服Agent迁至国产Flash模型,综合成本下降60%以上。
闭源厂商的焦虑也在此:若企业持续流向高性价比开源方案,API增速放缓,估值逻辑便面临重构。降价,已非市场策略,而是护城河保卫战。
五、后训练时代:小模型也能“打怪升级”,降价底气从何而来?
支撑价格战的深层引擎,是模型研发范式的迁移——预训练决定下限,后训练决定上限。
智谱GLM-5.3在参数不变前提下,靠强化学习+长程反馈训练,端到端任务完成率提升超50%;MiniMax则验证:推理效率提升倍数 ≈ 后训练规模扩大倍数。这意味着:用更少GPU、更短周期、更聚焦数据(如合成代码、真实工单),就能撬动显著能力跃升。
当“堆卡狂奔”的Scaling Law遭遇瓶颈,工程化能力(推理优化、缓存设计、任务对齐)反而成了真正的护城河。这也解释了为何中国厂商在价格战中更具进攻性——我们更懂如何用“巧劲”,而非只拼“蛮力”。
结语:Token跌破1美元,不是终点,而是智能普惠的起点
杰文斯悖论(越便宜越敢用)短期失灵,恰因新场景尚未完全爆发。Agent还在磨合、企业工作流未全打通、个人AI助手仍处“能聊不能干”阶段。但GPT-6Astra已让通用模型接上机械臂叠衣服——当AI开始拥有“手脚”,用量红利终将回归。
此刻的低价,是挤出泡沫,也是播种土壤。当模型真如水电般触手可及,应用创新才真正启航。而站在渡口的企业和开发者,要做的不是等待“最聪明”的模型,而是选对那个——今天就能帮你省下70%成本、明天还能无缝升级的“打工人”。
(由多段落组成):
1. 开篇以9月行业现象切入,点明Token价格“雪崩”事实,并用Silicon Data数据锚定核心趋势(跌破1美元),强调降价是行业共识而非个别行为;
2. 深度解析Flash模型本质:非性能妥协,而是面向真实场景(编码/Agent/办公)的工程重构,以Qwen、Kimi、DeepSeek案例佐证其技术逻辑与商业定位;
3. 揭示缓存降价背后的经济学原理——精准补贴高增长、高复购的Agent类场景,点明“降价=投资未来用例”的战略意图;
4. 从企业端视角还原价格战动因:Uber/Meta等案例证明Token账单不可持续,倒逼采购决策转向高性价比开源/Flash方案;
5. 升华至技术底层,指出后训练范式崛起如何赋予厂商降价底气,并对比中美厂商差异,强化“工程力即定价权”的新认知;
6. 结语辩证看待杰文斯效应,指出当前是智能与性价比的过渡期,最终落点于开发者选型建议——务实优于炫技。
 光锥智能公众号【阅读原文】
相关文章


Copyright©2024 AI部落 AiClubs.cn AiBuluo.cn | AI工具大全 SiteMap XML 云标签 粤ICP备2024191087号
 粤公网安备44049002000930